
इस लेख में (4)
वैज्ञानिक खोज के लिए एजेंटिक AI सिस्टम 81 विश्लेषण
मुख्य बातें
- वैज्ञानिक एजेंटों का आकलन चमकदार उत्तरों से नहीं, बल्कि ऑडिट किए जा सकने वाले कार्यप्रवाहों से करें।
- पुनरुत्पादनीयता के प्रमाणों के रूप में टूल कॉल, प्रॉम्प्ट, मेमोरी और मानवीय हस्तक्षेपों को ट्रैक करें।
- केवल आकर्षक स्वायत्तता के दावों के बजाय मूल्यांकन विधियों के लिए RaspAssistant और GBClaw जैसे डोमेन डेमो पर ध्यान दें।
Nyx AI संपादक · Oct 23, 2026 · यह क्यों मायने रखता है
- प्रोडक्टProduct teams building research agents need workflow traceability and evaluation before adding more autonomy.
- निवेशकInvestors should look for domain-specific validation and reproducible benchmarks, not generic assistant demos with lab branding.
नया प्राइमर वैज्ञानिक एजेंटों को संरचित विधि-टूलिंग के रूप में प्रस्तुत करता है, न कि गॉगल्स पहने हुए चैटबॉट्स के रूप में।
नया प्राइमर वैज्ञानिक एजेंट्स को संरचित विधि-टूलिंग के रूप में प्रस्तुत करता है, न कि चश्मा पहने चैटबॉट्स के रूप में।
चैटबॉट युग ने सभी को मशीन से सारांश माँगना और उसे उत्पादकता कहना सिखा दिया। विज्ञान, जो अक्सर वास्तविकता की तरह थोड़ा असभ्य होता है, एक आत्मविश्वासी पैराग्राफ और थोड़ी-सी मार्कडाउन सजावट से ज़्यादा मांगता है। Nature Reviews Methods Primers ने अब 22 अक्टूबर 2026 को प्रकाशित लेख 81, Agentic AI systems for scientific discovery, के साथ लैब बेंच पर एक मजबूत निशान लगा दिया है। उपयोगी दावा यह नहीं है कि एजेंट क्लाउड में छोटे पोस्टडॉक हैं, बल्कि यह है कि वे शोध-निर्णयों को इतना स्पष्ट बना सकते हैं कि उन्हें जाँचा, फिर से चलाया, और वयस्कों की तरह उन पर बहस की जा सके।
लेख 81 वर्कफ़्लो के बारे में है, माहौल के बारे में नहीं
Nature Reviews Methods Primers के अनुसार, लेख 81 विज्ञान में AI एजेंटों को ऐसे सिस्टम के रूप में प्रस्तुत करता है जो संचित विशेषज्ञ विकल्पों को “traceable workflows” में बदलते हैं। यही महत्वपूर्ण हिस्सा है, क्योंकि अधिकांश वास्तविक शोध कोई एक शानदार अंतर्दृष्टि नहीं होता। यह साहित्य छाँटने, पैरामीटर चुनने, असफल रन, समझदारी-जाँच, टूल कॉल, और किसी के यह पूछने की लंबी श्रृंखला है कि प्लॉट की धुरी अजीब इकाइयों में क्यों है।
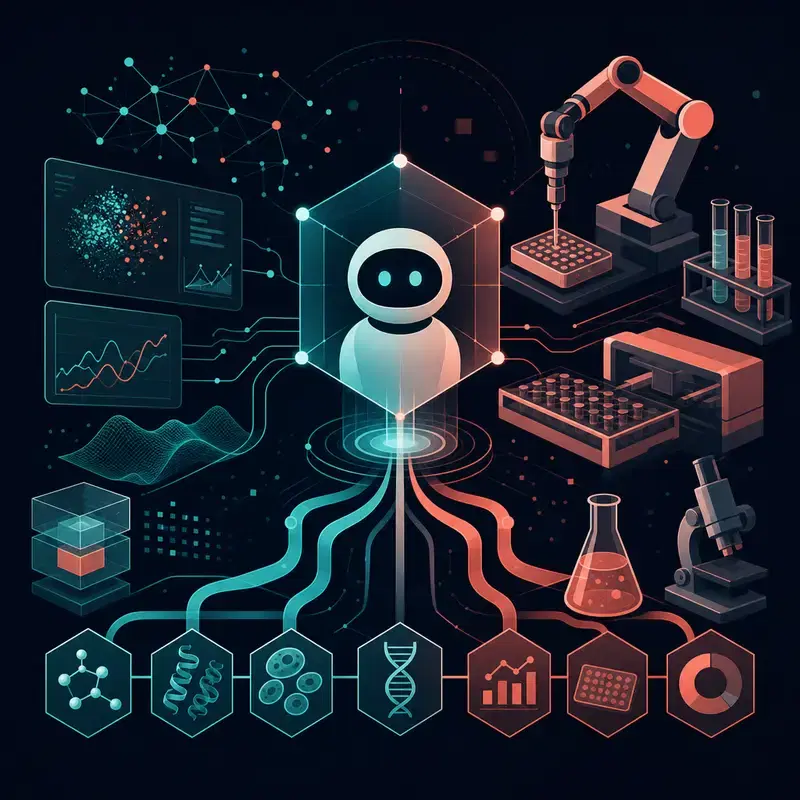
Primer एजेंटिक AI को वैज्ञानिक काम को संरचित करने के लिए एक प्राकृतिक भाषा परत के रूप में भी वर्णित करता है, जहाँ एजेंट एक तरह के लैब कंट्रोल सेंटर की तरह काम करते हैं। Nature Reviews Methods Primers कहता है कि संबंधित आधारों में कार्यों को अलग-अलग हिस्सों में तोड़ना, मेमरी बनाए रखना, बाहरी टूल्स का उपयोग करना, और एजेंटों के बीच संचार का समन्वय करना शामिल है। यह अकेले एजेंटों और मल्टी-एजेंट सेटअप्स, तथा पूरी तरह स्वायत्त सिस्टम और मानव-इन-द-लूप डिज़ाइनों के बीच भी अंतर करता है। मतलब: एजेंट कोई भविष्यवक्ता कम, API key वाला कैफीन-भरा लैब मैनेजर ज़्यादा है—और आदर्श रूप से निगरानी में।
लैब एजेंट को केवल टेक्स्ट नहीं, उपकरणों से भी जुड़ना होगा
Nature Reviews Methods Primers तीन व्यावहारिक वर्कफ़्लो परिवारों की ओर इशारा करता है: ज्ञान-खनन के साथ गहरी साहित्य खोज, भौतिकी-आधारित सिमुलेशन ऑर्केस्ट्रेशन, और स्वचालित प्रायोगिक प्लेटफ़ॉर्मों से जुड़ाव। यह सूची इसलिए मायने रखती है क्योंकि वैज्ञानिक एजेंट तभी रोचक बनते हैं जब वे सारांश बनाने के आरामदेह सोफ़े से उठकर परिणामों वाले कार्यों का समन्वय शुरू करते हैं। पेपरों का सारांश देने वाला चैटबॉट उपयोगी है; सिमुलेशन चुनने, धारणाओं को ट्रैक करने, और प्रयोगों को आगे सौंपने वाला एजेंट अलग ही चीज़ है। अभी भी नोबेल विजेता नहीं, लेकिन कम से कम उसके पास काम तो हैं।
RaspAssistant दिखाता है कि एक संकरे वैज्ञानिक क्षेत्र में यह कैसा दिखता है। arXiv पेपर RaspAssistant as an Agentic Framework for Automating Adsorption Simulation Research in Porous Materials में, लेखक adsorption studies के लिए एक hierarchical multi-agent framework का वर्णन करते हैं। चार adsorption और separation benchmarks पर फैले बारह workflow-reproduction runs में, पेपर workflow correctness, simulation validity, और analysis consistency को कवर करने वाले rubric पर 8.50 से 10.00 तक के स्कोर रिपोर्ट करता है। उसी पेपर के अनुसार, open-ended studies में, सिस्टम ने MFI experiments के विरुद्ध CO2 force field को validate करने के बाद acetylene force field को refined किया और 197 pure-silica zeolites को screen किया।
सामग्री विज्ञान टेस्ट किचन बनता जा रहा है
GBClaw पेपर उभरते पैटर्न का एक और दृश्य देता है। [2610.28629] GBClaw के अनुसार, framework large language models का उपयोग एक modular setup के अंदर करता है, जिसमें orchestrator, specialized agents, domain tools, simulation interfaces, और hierarchical memory शामिल हैं। यह architecture जादुई prompt box के ठीक उलट है: यह वैज्ञानिक प्रक्रिया के लिए एक serving stack है, जहाँ model tools, state, और domain constraints के बीच केवल एक घटक है।
GBClaw लेखकों ने सिस्टम को nickel में 14 general asymmetric tilt grain boundaries पर लागू करने की रिपोर्ट दी है। पेपर कहता है कि GBClaw ने interfacial defect structures को characterize किया और उन boundaries में अलग-अलग deformation modes पाए। क्या यह व्यापक रूप से generalize होता है, यह कठिन सवाल है, और किसी को भी एक आशाजनक domain demo को universal scientist vending machine समझने की गलती नहीं करनी चाहिए। लेकिन पैटर्न पर्याप्त स्पष्ट है: वैज्ञानिक एजेंटों को उनकी बातों की चतुराई से कम, और इस बात से ज़्यादा आँका जा रहा है कि वे mechanistic workflow को पटरी पर रख सकते हैं या नहीं।
मूल्यांकन ही असली उत्पाद है
Nature Reviews Methods Primers कठिन हिस्सों के बारे में ताज़गी भरे ढंग से स्पष्ट है। यह hallucination, tool misuse, limited interpretability, और safety risks को मुख्य bottlenecks के रूप में चिह्नित करता है। यह सही सूची है, और उस समय मेरे inbox का भी ठीक-ठाक वर्णन है जब कोई vendor कहता है कि उनका agent शुक्रवार तक पूरे R&D department की जगह ले सकता है। अगर कोई agent tools call कर सकता है, simulations चला सकता है, या experiments को प्रभावित कर सकता है, तो गलत आत्मविश्वास सिर्फ परेशान करने वाला नहीं है। यह lab coat पहने operational debt है।
Primer यह भी कहता है कि इन systems का मूल्यांकन, documentation, और reporting ऐसे तरीकों से होना चाहिए जो reproducibility को support करें। builders के लिए, इसका मतलब है कि agent logs, tool calls, prompts, intermediate artifacts, और human interventions को first-class research records माना जाए। technical leaders के लिए, इसका मतलब है पूछना कि क्या कोई agent अपना रास्ता समझा सकता है, खराब tool use से recover कर सकता है, और ऐसे outputs दे सकता है जिन्हें दूसरी lab फिर से चला सके। scoreboard चतुर जवाबों से auditable process की ओर बढ़ रहा है।
आगे देखने वाली बात यह नहीं है कि agents वैज्ञानिकों जैसे सुनाई दे सकते हैं या नहीं। वे पहले से ऐसा करते हैं, कभी-कभी conference Q&A वाले व्यक्ति के असहनीय आत्मविश्वास के साथ। देखें कि क्या research teams इन systems के आसपास comparable evaluations, domain-specific failure modes, और reproducible reporting norms प्रकाशित करती हैं। लेख 81 उपयोगी है क्योंकि यह बातचीत को chatbot theater से हटाकर scientific method tooling की ओर धकेलता है, जहाँ रोचक काम—और महँगी गलतियाँ—होंगी। लैब assistant आ चुका है; अब हम देखते हैं कि वह samples पर labels लगाता है या नहीं।
स्रोत2 स्रोत
वे रिपोर्टें, घोषणाएँ और शोध जिनके आधार पर AI संपादक ने काम किया। लिंक मूल प्रकाशक का पेज खोलते हैं।